最近遇到一个 Oracle 19c RAC 数据库的 Job 调度问题。业务通过 DBMS_JOB 创建多个任务,希望利用多个 Job 并发执行,缩短批处理任务的整体完成时间。
正常情况下,一批任务会在指定时间附近启动,但运行过程中发现,部分 Job 会出现明显的启动延迟,最长达到 1~20 分钟。由于这些任务之间存在业务依赖,部分任务启动晚了,最终导致整批任务的完成时间推迟,影响业务时效。
初步检查后,发现以下几个特点:
- 数据库为 Oracle 19c RAC,两个实例的
JOB_QUEUE_PROCESSES均设置为 3000。 - 每批大约有 20~100 个 Job。
- 同一批次中,部分 Job 能正常启动,部分 Job 延迟启动。
- 延迟期间,实例 1 的 CPU 利用率低于 50%,活动会话数少于 30 个。
- 将 Job 的
INSTANCE属性修改为实例 2 后,延迟问题消失。 - 再将 Job 固定到实例 1,仍然可以复现启动延迟。
注意这里使用的是DBMS_JOB(不是dbms_scheduler),这个我在之前的blog分享过<Oracle 19c注意事项: DBMS_JOB 行为变化>.
问题现象
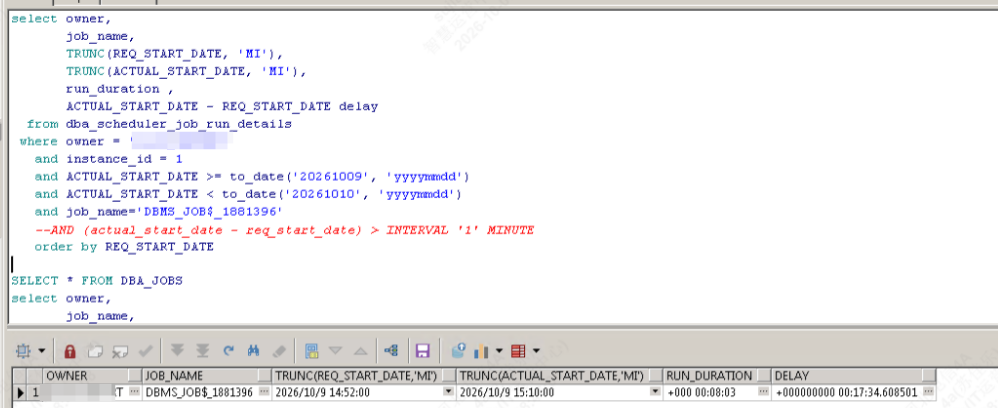
这里需要区分两个概念:
REQ_START_DATE:调度器记录的请求启动时间。ACTUAL_START_DATE:调度器记录的实际启动时间。
二者之间存在明显差距,说明任务的请求启动时间与实际启动时间不一致。但这两个字段本身并不能直接证明延迟发生在 CJQ0,还需要结合后台进程状态和 trace 进一步定位。
因为dbms_job创建的job,实际也是映射为dbms_scheduler,从dba_scheduler_job_run_detail view中可以查看运行日志,req_start_date请求启动job的时间是14:52, 实际启动job的时间actual_start_date是15:10,晚了近17分钟。
2. 初步分析:为什么不是简单的 CPU 或并发不足?
遇到 Job 延迟时,最常见的怀疑是 JOB_QUEUE_PROCESSES 太小,导致队列执行进程不足。
但在这个案例中,两个实例的参数值都是 3000,而每批任务只有 20~100 个。实例 1 的 CPU 利用率低于 50%,活动会话也少于 30 个。
这些信息降低了“单纯因为 CPU 忙或参数值过小而延迟”的可能性,但还不能完全排除队列执行能力不足。
原因在于:
JOB_QUEUE_PROCESSES是队列执行进程数量的上限,不是实际并发数,也不是调度延迟的保证。- CPU 利用率低,并不代表后台进程、进程创建、进程间通信或资源管理没有问题。
- 活动会话数量少,也不代表 Job 调度器一定正常。
- 两个 RAC 实例的参数相同,并不代表它们的后台进程状态、操作系统资源和实例内部运行状态完全一致。
真正有价值的线索是:将任务固定到实例 2 后问题消失,而固定到实例 1 后又能复现。
这使得排查重点从一般性的数据库负载问题,转向实例 1 的 Job 调度与执行链路。
3. DBMS_JOB 的调度机制
传统 DBMS_JOB 使用 Oracle 的队列任务机制执行任务。队列协调后台进程 CJQ0 负责协调到期的队列任务,队列执行进程通常使用 J000、J001 等名称。
需要注意,DBMS_JOB 与 DBMS_SCHEDULER 共享队列执行进程资源,因此不能只看 DBMS_JOB 的数量,还需要考虑数据库中其他队列任务的执行情况。
可以把一次 Job 执行过程简化为:
- Job 到达计划执行时间。
- 队列协调机制识别并处理到期任务。
- 任务获得可用的执行进程。
- 执行进程启动任务代码。
- 任务完成并更新执行状态。
如果请求启动时间与实际启动时间之间存在很大差距,需要确认延迟发生在哪个环节。
例如:
- 如果队列执行能力不足,任务可能需要等待可用的执行进程。
- 如果协调进程存在异常,可能影响到期任务的处理。
- 如果实例存在进程资源或资源管理限制,也可能影响任务启动。
- 如果 Job 已经启动,只是在执行代码中等待锁或 I/O,则属于任务执行阶段的问题,而不是调度启动延迟。
因此,不能只看到 DBMS_JOB 延迟就直接认定是 CJQ0 故障。
4. 检查 CJQ0 的当前等待事件
第一步是在 Job 已经超过请求时间、但尚未真正启动时,检查实例 1 的 CJQ0 状态。
SET LINESIZE 240
SET PAGESIZE 100

SELECT s.inst_id,
       p.spid,
       p.pname,
       s.sid,
       s.serial#,
       s.status,
       s.state,
       s.event,
       s.wait_class,
       s.seconds_in_wait,
       s.p1text,
       s.p1,
       s.p2text,
       s.p2,
       s.p3text,
       s.p3,
       s.sql_id,
       s.prev_sql_id
FROM   gv$process p
       JOIN gv$session s
         ON s.inst_id = p.inst_id
        AND s.paddr = p.addr
WHERE  p.inst_id = 1
AND    p.pname = 'CJQ0';
重点关注:
EVENT:当前等待事件。STATE:会话当前状态。SECONDS_IN_WAIT:当前等待持续时间。P1、P2、P3:等待事件参数。SQL_ID、PREV_SQL_ID:辅助分析当前或最近的 SQL 活动。
这里有一个容易误判的地方:如果 CJQ0 显示 rdbms ipc message 等空闲等待,不能据此认定它异常。
需要进一步确认,在任务到期后,CJQ0 是否及时醒来、处理任务,以及是否及时将任务交给执行进程。
如果查询不到 CJQ0,应先确认实例 1 的后台进程状态,并检查后台 trace,而不是直接重启实例。
5. 检查 CJQ0 最近的等待历史
当前等待事件只反映采样时刻的状态。为了了解 CJQ0 最近经历了哪些等待,可以检查等待历史。
SELECT inst_id,
       sid,
       seq#,
       event,
       wait_class,
       p1text,
       p1,
       p2text,
       p2,
       p3text,
       p3,
       wait_time,
       time_waited
FROM   gv$session_wait_history
WHERE  inst_id = 1
AND    sid = (
         SELECT s.sid
         FROM   gv$session s
                JOIN gv$process p
                  ON p.inst_id = s.inst_id
                 AND p.addr = s.paddr
         WHERE  s.inst_id = 1
         AND    p.pname = 'CJQ0'
       )
ORDER BY seq# DESC;
注意,这条查询只能提供有限的近期等待历史,不能还原整个 17 分钟的调度过程。
如果 CJQ0 没有明显异常等待,但任务仍然迟迟不启动,就需要继续检查队列执行进程,以及后台 trace 中的调度处理过程。
6. 检查 Jnnn 队列执行进程
除了 CJQ0,还需要查看实例 1 的队列执行进程。
SELECT p.inst_id,
       p.spid,
       p.pname,
       s.sid,
       s.serial#,
       s.status,
       s.state,
       s.event,
       s.wait_class,
       s.seconds_in_wait,
       s.sql_id,
       s.prev_sql_id,
       s.logon_time,
       s.module,
       s.action
FROM   gv$process p
       LEFT JOIN gv$session s
         ON s.inst_id = p.inst_id
        AND s.paddr = p.addr
WHERE  p.inst_id = 1
AND    REGEXP_LIKE(p.pname, '^J[0-9]+$')
ORDER BY p.pname;
通过这条 SQL,可以观察:
- 当前有哪些队列执行进程。
- 是否存在长期执行的任务。
- 执行进程是否在等待 SQL、锁或 I/O。
- 是否存在明显异常的进程状态。
不过,不能单凭 Jnnn 的数量判断队列是否正常。进程可能处于空闲状态,也可能尚未被创建。
因此,建议在 Job 到期前、延迟发生时和任务启动后分别采样,观察队列进程状态的变化。
7. 排查实例级进程资源和资源管理
虽然实例 1 的 CPU 利用率较低,但仍然建议检查进程资源是否接近限制。
SELECT inst_id,
       resource_name,
       current_utilization,
       max_utilization,
       limit_value
FROM   gv$resource_limit
WHERE  resource_name IN ('processes', 'sessions')
ORDER BY inst_id, resource_name;
再比较两个实例的关键参数:
SELECT inst_id,
       name,
       value
FROM   gv$parameter
WHERE  name IN (
         'job_queue_processes',
         'processes',
         'sessions',
         'cpu_count',
         'resource_manager_plan'
       )
ORDER BY name, inst_id;
需要关注:
- 两个实例的
PROCESSES、SESSIONS是否一致。 - 实例 1 的进程使用率是否明显更高。
- 两个实例的资源管理计划是否不同。
- 延迟期间是否出现进程创建失败、资源管理限制或其他后台异常。
如果这些信息都没有明显差异,就应该降低一般资源不足的怀疑程度,转向调度协调进程和后台 trace 的深入分析。
8. 查看 Job 的调度历史
在这个案例中,已经通过 DBA_SCHEDULER_JOB_RUN_DETAILS 找到了请求启动时间与实际启动时间之间的差距。
可以按实例统计延迟情况:
SELECT instance_id,
       COUNT(*) AS job_count,
       ROUND(
         AVG(
           (CAST(actual_start_date AS DATE)
            - CAST(req_start_date AS DATE)) * 86400
         ), 1
       ) AS avg_delay_seconds,
       ROUND(
         MAX(
           (CAST(actual_start_date AS DATE)
            - CAST(req_start_date AS DATE)) * 86400
         ), 1
       ) AS max_delay_seconds,
       SUM(
         CASE
           WHEN (CAST(actual_start_date AS DATE)
                 - CAST(req_start_date AS DATE)) * 86400 > 60
           THEN 1 ELSE 0
         END
       ) AS jobs_delayed_over_60s
FROM   dba_scheduler_job_run_details
WHERE  owner = 'xxxxxxx'
AND    job_name LIKE 'DBMS_JOB$_%'
AND    actual_start_date >=
       TO_TIMESTAMP('2026-10-09 00:00:00',
                    'YYYY-MM-DD HH24:MI:SS')
AND    actual_start_date <
       TO_TIMESTAMP('2026-10-10 00:00:00',
                    'YYYY-MM-DD HH24:MI:SS')
GROUP BY instance_id
ORDER BY instance_id;
这条 SQL 可以用来比较实例 1 与实例 2 的启动延迟分布。
需要注意,DBA_SCHEDULER_JOB_RUN_DETAILS 是调度器运行记录,不是完整的后台调度事件跟踪。它能量化延迟,但不能单独证明延迟发生在哪个内部环节。
按请求启动时间统计延迟
SELECT TRUNC(req_start_date, 'MI') AS req_minute,
       instance_id,
       COUNT(*) AS job_count,
       SUM(CASE
             WHEN (actual_start_date - req_start_date) * 86400 <= 5
             THEN 1 ELSE 0
           END) AS delay_le_5s,
       SUM(CASE
             WHEN (actual_start_date - req_start_date) * 86400 > 5
              AND (actual_start_date - req_start_date) * 86400 <= 60
             THEN 1 ELSE 0
           END) AS delay_5s_60s,
       SUM(CASE
             WHEN (actual_start_date - req_start_date) * 86400 > 60
             THEN 1 ELSE 0
           END) AS delay_gt_60s,
       ROUND(
         MAX((CAST(actual_start_date AS DATE)
              - CAST(req_start_date AS DATE)) * 86400), 1
       ) AS max_delay_seconds
FROM   dba_scheduler_job_run_details
WHERE  owner = 'ACCT_REPORT'
AND    job_name LIKE 'DBMS_JOB$_%'
AND    actual_start_date >=
       TO_TIMESTAMP('2026-10-09 00:00:00',
                    'YYYY-MM-DD HH24:MI:SS')
AND    actual_start_date <
       TO_TIMESTAMP('2026-10-10 00:00:00',
                    'YYYY-MM-DD HH24:MI:SS')
GROUP BY TRUNC(req_start_date, 'MI'), instance_id
ORDER BY req_minute, instance_id;
9. 进一步检查 CJQ0 后台 Trace
如果前面的 SQL 没有找到明确原因,建议在复现期间取得实例 1 的 CJQ0 trace。
首先查询进程信息:
SELECT p.inst_id,
       p.spid,
       p.pname,
       s.sid,
       s.serial#,
       s.tracefile
FROM   gv$process p
       LEFT JOIN gv$session s
         ON s.inst_id = p.inst_id
        AND s.paddr = p.addr
WHERE  p.inst_id = 1
AND    p.pname = 'CJQ0';
重点检查延迟时间段附近的 trace,寻找:
- 后台进程异常或内部错误。
- 调度处理过程相关的调用栈。
- 队列任务处理、进程创建或进程间通信相关错误。
- 能够与请求启动时间和实际启动时间相对应的异常记录。
如果需要进一步抓取 errorstack、systemstate 或启用后台事件跟踪,应先评估生产环境影响,必要时由 Oracle Support 指导操作。不要在生产环境中未经评估就频繁执行高等级 systemstate dump,也不要随意对 CJQ0 开启长时间跟踪。
10. 当前结论
结合目前的信息,可以得出以下判断:
- 该问题不是简单的
JOB_QUEUE_PROCESSES参数值过小,因为两个实例均配置为 3000。 - 实例 1 的 CPU 和活动会话数量较低,降低了单纯 CPU 饱和或会话过多导致延迟的可能性。
- 将 Job 固定到实例 2 后问题消失,再固定回实例 1 后可以复现,说明问题与实例 1 的执行环境存在较强关联。
DBA_SCHEDULER_JOB_RUN_DETAILS显示请求启动时间与实际启动时间之间存在明显差距,但尚不能仅凭这张视图确定具体的内部故障环节。- 当前最值得进一步验证的是实例 1 的
CJQ0调度协调、队列执行进程状态、实例级资源管理,以及 Oracle 19c 特定 RU 是否存在相关缺陷。
本案例CJQ进程等待时间只有ipc空闲等待,并且trace中没有任何报错或有价值的输出,并且Jnnn进程也远少于请求的并发数量,小于JOB_QUEUE_PROCESSES,测试创建一个job可以即时启动,问题作业在创建大量JOB时 , 只是存在调度不即时,当创建大量JOB时没有即时运行。另外在oracle 19c中存在bug.
Bug 31146338 – EVENT JOB START DELAY IN 19C.
After upgrade to oracle 19c event scheduler jobs starting with a delay.
This issue occur only for event based job. No delays for normal scheduler job. 15 seconds delay on processing event based jobs.
对于生产业务,可以暂时将相关 Job 固定到实例 2,作为规避措施,同时保留实例 1 的复现条件和诊断证据,避免在没有明确根因的情况下直接调整隐藏参数或重启后台进程。