PostgreSQL 的 INCLUDE 索引(从 PostgreSQL 11 开始支持)主要解决的是:在不把额外列放进索引键(search key)的前提下,实现真正的覆盖索引(covering index),从而让查询能走 Index-Only Scan,避免回表(heap access)。
核心问题是什么?
普通索引扫描的流程是:
- 用索引找到符合条件的行(通过索引键)。
- 再根据索引里的 TID 去堆表(heap)取实际需要的列。
当查询需要的列多于索引键列时,就必须回表。回表是随机 I/O,在大表、返回较多行时往往成为性能瓶颈。
以前(PostgreSQL 11 之前)想做覆盖索引,只能把所有需要的列都加进复合索引的键里:
CREATE INDEX ON tab (x, y); -- y 也成为排序键的一部分这样虽然能 Index-Only Scan,但有明显副作用:
- 索引键变宽 → 内部节点(非叶子节点)更大 → 树可能更深、缓存效率下降。
- 维护排序开销增加(即使从不按 y 过滤/排序)。
- 唯一性约束会把 y 也算进去(如果不希望这样,就麻烦了)。
- 某些数据类型本身就不适合作为 B-tree 键。
INCLUDE 怎么解决?
INCLUDE 把列分成两类:
- 键列(key columns):参与排序、定位、唯一性约束,存在于整棵 B-tree。
- 包含列(INCLUDE / non-key / payload columns):只存在于叶子节点,纯粹用来“带数据”,不参与搜索、排序、唯一性判断。
官方例子:
-- 查询经常是:SELECT y FROM tab WHERE x = 'key';
CREATE INDEX tab_x_y ON tab (x) INCLUDE (y);
这样查询可以直接从索引拿到 y,走 Index-Only Scan,不用回表。而 y 不会让索引键变宽,也不会影响唯一性。
很多文章会简单解释:
INCLUDE用来创建覆盖索引(Covering Index),从而帮助 PostgreSQL 使用 Index Only Scan。
这个说法没有错,但其实并不完整。
相比直接把列加进键的优势
| 方面 | 普通复合索引 (x, y) | INCLUDE (y) |
|---|---|---|
| 是否参与排序/定位 | 是 | 否 |
| 是否影响唯一性 | 是 | 否(唯一性只看键列) |
| 内部节点大小 | 更大 | 更小(INCLUDE 列被截断) |
| 维护开销 | 较高(要维护完整排序) | 相对较低 |
| 数据类型限制 | 必须支持对应 opclass | 几乎无限制(只要能存) |
| 适用场景 | 需要按这些列过滤/排序 | 只需要 SELECT 这些列,不需要过滤 |
额外好处:
- 可以 INCLUDE 那些本来没法建 B-tree 索引的类型。
- 对 UNIQUE 索引特别有用:可以在保证某列唯一的同时,把其他列“顺带”放进索引,方便覆盖查询。
DEMO
drop table demo;

create table demo ( id text , value text)

insert into demo(id, value)
           select
             g::text,
             lpad(md5((g%1000)::text),256,'xxxxx')
from generate_series(1,1000000) g
;


create index demo_idx1
  on demo(id,value);

vacuum analyze demo;

explain (verbose, analyze, buffers)
select value from demo
  where id <= '10'
;
kingbase=# explain (verbose, analyze, buffers)
kingbase-# select value from demo
kingbase-#   where id <= '10'
kingbase-# ;
                                                             QUERY PLAN
------------------------------------------------------------------------------------------------------------------------------------
 Index Only Scan using demo_idx1 on public.demo  (cost=0.42..1774.57 rows=9951 width=260) (actual time=0.024..0.025 rows=2 loops=1)
   Output: value
   Index Cond: (demo.id <= '10'::text)
   Heap Fetches: 0
   Buffers: shared hit=4
 Planning Time: 0.297 ms
 Execution Time: 0.051 ms
(7 rows)
Note: 这里我使用了postgresql系的Kingbase v8数据库, 可见上面普通的索引创建方式可以正常走index only scan.
kingbase=# create index demo_idx2
kingbase-#   on demo(id) include (value)
kingbase-# ;
CREATE INDEX
kingbase=# vacuum analyze demo;
VACUUM
kingbase=# explain (verbose, analyze, buffers)
kingbase-# select value from demo
kingbase-#   where id <= '10'
kingbase-# ;
                                                             QUERY PLAN
------------------------------------------------------------------------------------------------------------------------------------
 Index Only Scan using demo_idx2 on public.demo  (cost=0.42..1774.57 rows=9951 width=260) (actual time=0.009..0.010 rows=2 loops=1)
   Output: value
   Index Cond: (demo.id <= '10'::text)
   Heap Fetches: 0
   Buffers: shared hit=4
 Planning Time: 0.290 ms
 Execution Time: 0.036 ms
(7 rows)
Note: 创建了include index , index only scan使用了新的索引,但是因为cost太接近,无法区别差距。
查看两个索引的大小
kingbase=# select relname, pg_size_pretty(pg_relation_size(oid))
kingbase-#            from pg_class where relname in ('demo_idx1','demo_idx2')
kingbase-# ;
  relname  | pg_size_pretty
-----------+----------------
 demo_idx1 | 314 MB
 demo_idx2 | 314 MB
(2 rows)
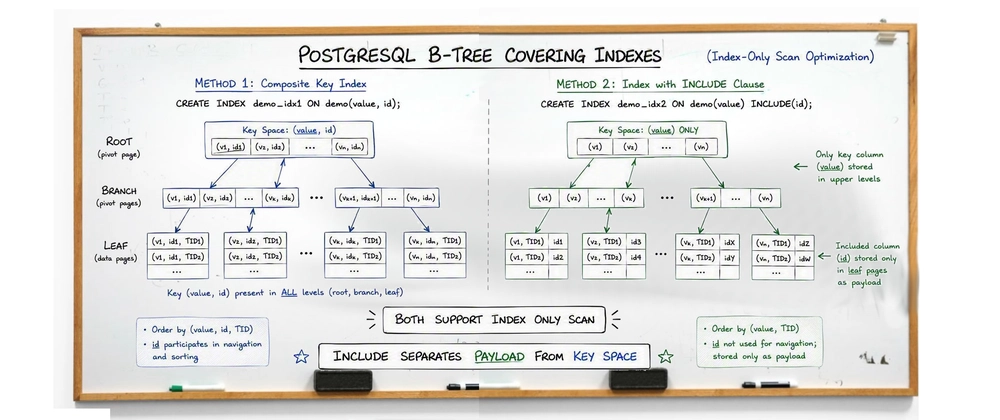
Note: 这两个索引大小相同, 两个索引的叶子节点都存储了id和value值,所以都支持index only scan, 但是区别在B树的分支节点(Key),ind1是基于id和value排序,而ind2只有id排序,value以附加值只出现在叶子节点,不出出现以上层。
借用FrankPachot的图
kingbase=# select indexrelid::regclass,indnatts, indnkeyatts from pg_index
kingbase-#            where indexrelid='demo_idx1'::regclass;
 indexrelid | indnatts | indnkeyatts
------------+----------+-------------
 demo_idx1  |        2 |           2
(1 row)

kingbase=# select indexrelid::regclass,indnatts, indnkeyatts from pg_index
kingbase-#            where indexrelid='demo_idx2'::regclass;
 indexrelid | indnatts | indnkeyatts
------------+----------+-------------
 demo_idx2  |        2 |           1
(1 row)
Note: 从索引的属性列可以看出。由于内部页面仅占索引的一小部分,因此大小差异很小,这种差异通常并非选择 INCLUDE 而不是将列添加到键的理由。
使用pageinspect观察
CREATE TABLE t_include2 (
    id integer,
    category integer,
    payload text
);

INSERT INTO t_include2
SELECT
    i,
    1,
    'payload-' || i
FROM generate_series(1, 50000) i;

CREATE INDEX idx_normal2
ON t_include2(category, id);

CREATE INDEX idx_include2
ON t_include2(category)
INCLUDE (id);

highgo=# SELECT
highgo-#     p.blkno,
highgo-#     s.type,
highgo-#     s.live_items,
highgo-#     s.dead_items,
highgo-#     s.avg_item_size,
highgo-#     s.free_size
highgo-# FROM generate_series(1, 100) AS p(blkno)
highgo-# CROSS JOIN LATERAL bt_page_stats('idx_normal2', p.blkno) AS s
highgo-# where type!='l' ; --因为leaf节点都一样,我们排除leaf
 blkno | type | live_items | dead_items | avg_item_size | free_size
-------+------+------------+------------+---------------+-----------
     3 | r    |        137 |          0 |            15 |      5416
(1 row)

-------------------
type:
l = leaf
i = internal
r = root
--------------------

highgo=# select itemoffset, ctid, itemlen, nulls, vars, dead, htid, encode(decode(replace(substr(data,4),' ',''), 'hex'),'escape'), data
highgo-#            from bt_page_items('idx_normal2', 3) order by itemoffset limit 4
highgo-# ;
 itemoffset | ctid  | itemlen | nulls | vars | dead | htid |            encode            |          data
------------+-------+---------+-------+------+------+------+------------------------------+-------------------------
          1 | (1,0) |       8 | f     | f    |      |      |                              |
          2 | (2,2) |      16 | f     | f    |      |      | \000\000\000o\x01\000\000    | 01 00 00 00 6f 01 00 00
          3 | (4,2) |      16 | f     | f    |      |      | \000\000\000\335\x02\000\000 | 01 00 00 00 dd 02 00 00
          4 | (5,2) |      16 | f     | f    |      |      | \000\000\000K\x04\000\000    | 01 00 00 00 4b 04 00 00
(4 rows)

highgo=# SELECT
highgo-#     p.blkno,
highgo-#     s.type,
highgo-#     s.live_items,
highgo-#     s.dead_items,
highgo-#     s.avg_item_size,
highgo-#     s.free_size
highgo-# FROM generate_series(1, 100) AS p(blkno)
highgo-# CROSS JOIN LATERAL bt_page_stats('idx_include2', p.blkno) AS s
highgo-# where type!='l'
highgo-# order by blkno desc limit 100;
 blkno | type | live_items | dead_items | avg_item_size | free_size
-------+------+------------+------------+---------------+-----------
     3 | r    |        137 |          0 |            23 |      4328
(1 row)

highgo=# select itemoffset, ctid, itemlen, nulls, vars, dead, htid, encode(decode(replace(substr(data,4),' ',''), 'hex'),'escape'), data
highgo-#            from bt_page_items('idx_include2', 3) order by itemoffset limit 4
highgo-# ;
 itemoffset |   ctid   | itemlen | nulls | vars | dead |  htid   |            encode            |          data
------------+----------+---------+-------+------+------+---------+------------------------------+-------------------------
          1 | (1,0)    |       8 | f     | f    |      |         |                              |
          2 | (2,4097) |      24 | f     | f    |      | (2,52)  | \000\000\000\000\000\000\000 | 01 00 00 00 00 00 00 00
          3 | (4,4097) |      24 | f     | f    |      | (4,104) | \000\000\000\000\000\000\000 | 01 00 00 00 00 00 00 00
          4 | (5,4097) |      24 | f     | f    |      | (6,156) | \000\000\000\000\000\000\000 | 01 00 00 00 00 00 00 00
(4 rows)
Note: idx_normal2 的root有Key = category + id,而idx_include2的Key = category,所以data只有01.
Oracle为什么没有这种类型索引呢?
Oracle 对“唯一约束”和“索引”的区分更灵活。 你可以创建一个非唯一索引,只要它的最左边几列正好是唯一约束需要的列,Oracle 就可以用这个非唯一索引来强制执行唯一性约束。
CREATE INDEX idx ON table (id, payload);  -- 这是普通(非唯一)索引
ALTER TABLE table ADD UNIQUE (id) USING INDEX idx;
只要唯一键是索引键的前缀,Oracle 就能用这个索引来保证唯一性。 但是Postgresql不可以,必须用唯一索引,键必须完全匹配。
如果在PostgreSQL中想给主键/唯一键增加额外列必须用 INCLUDE,否则会改变唯一性.
CREATE UNIQUE INDEX ... ON table (id) INCLUDE (col1, col2);
-- 或者直接在主键上写
ALTER TABLE ... ADD PRIMARY KEY (id) INCLUDE (col1, col2);
简单对比
| 特性 | PostgreSQL | Oracle |
|---|---|---|
| 唯一约束如何实现 | 必须用唯一索引,键必须完全匹配 | 可以用非唯一索引(前缀匹配即可) |
| 想给主键索引加额外列 | 必须用 INCLUDE,否则会改变唯一性 | 直接把额外列加进索引键即可 |
| 覆盖索引(Index-Only) | 用 INCLUDE 实现 | 直接把列加进索引即可 |
Btree索引的去重机制
即使完全忽略 INCLUDE 列本身占用的存储空间,带有 INCLUDE 的 B-tree 索引也可能比“只包含相同键列的普通 B-tree 索引”更大。
原因是它无法使用 PostgreSQL 的 B-tree 去重(deduplication)机制,从而失去了原本可以大幅节省空间的“倒排列表(posting list)压缩”机会。
普通 B-tree 索引的去重机制(PostgreSQL 13+)
- 当很多行的索引键值完全相同时,普通 B-tree 不会为每一行都存一份完整的键值。
- 它会把相同的键值只存一次,然后后面跟着一个紧凑的 posting list(倒排列表),里面只记录指向这些行的 TID(行指针)。
- 这种压缩效果非常显著,尤其是在低基数列(比如状态、类型、布尔值、外键等高重复值)上,索引体积可以缩小到原来的 1/2~1/4 甚至更小。
带有 INCLUDE 的索引为什么不能用这个机制
- 官方文档明确写明:B-tree deduplication is never used with indexes that have a non-key column.
INCLUDE indexes can never use deduplication. - 因为 INCLUDE 列是非键列,每条叶子元组都必须携带自己的 INCLUDE 数据。
不同行即使键值相同,INCLUDE 列的值通常也不同,无法把它们合并成一个“键值 + posting list”的结构。 - 因此,系统干脆完全禁用去重,每条记录都按完整元组存储。
结果
- 假设你有一个普通索引:CREATE INDEX ON t (status);
- 和带 INCLUDE 的索引:CREATE INDEX ON t (status) INCLUDE (payload);
- 即使 payload 列完全不占空间(或者你把它想成 0 字节),带 INCLUDE 的那个索引仍然会更大,因为它失去了 posting list 压缩的机会。
INCLUDE 虽然让索引变成了覆盖索引(支持 Index-Only Scan),但代价之一是彻底放弃了 B-tree 的去重压缩。所以在键值重复率很高的场景下,索引体积可能会比你预期的更大。
使用时的注意点
- 只有真正能触发 Index-Only Scan 才有价值。如果查询还要拿其他不在索引里的列,或者 visibility map 不干净(需要经常回表做可见性检查),收益会打折。
- INCLUDE 列会增大叶子节点体积,索引整体还是会变大,写入/更新成本也会上升。
- 不要把经常出现在 WHERE/ORDER BY/JOIN 条件里的列放进 INCLUDE,那些应该放进键列。
- 目前主要支持 B-tree(以及后来扩展的 GiST/SP-GiST),表达式不能作为 INCLUDE 列。
一句话总结:INCLUDE 解决的是“我想让索引覆盖查询需要的额外列,但又不想把这些列变成真正的索引键,以免索引变宽、排序开销增加、唯一性语义改变”的问题。它让覆盖索引变得更干净、更高效。